-
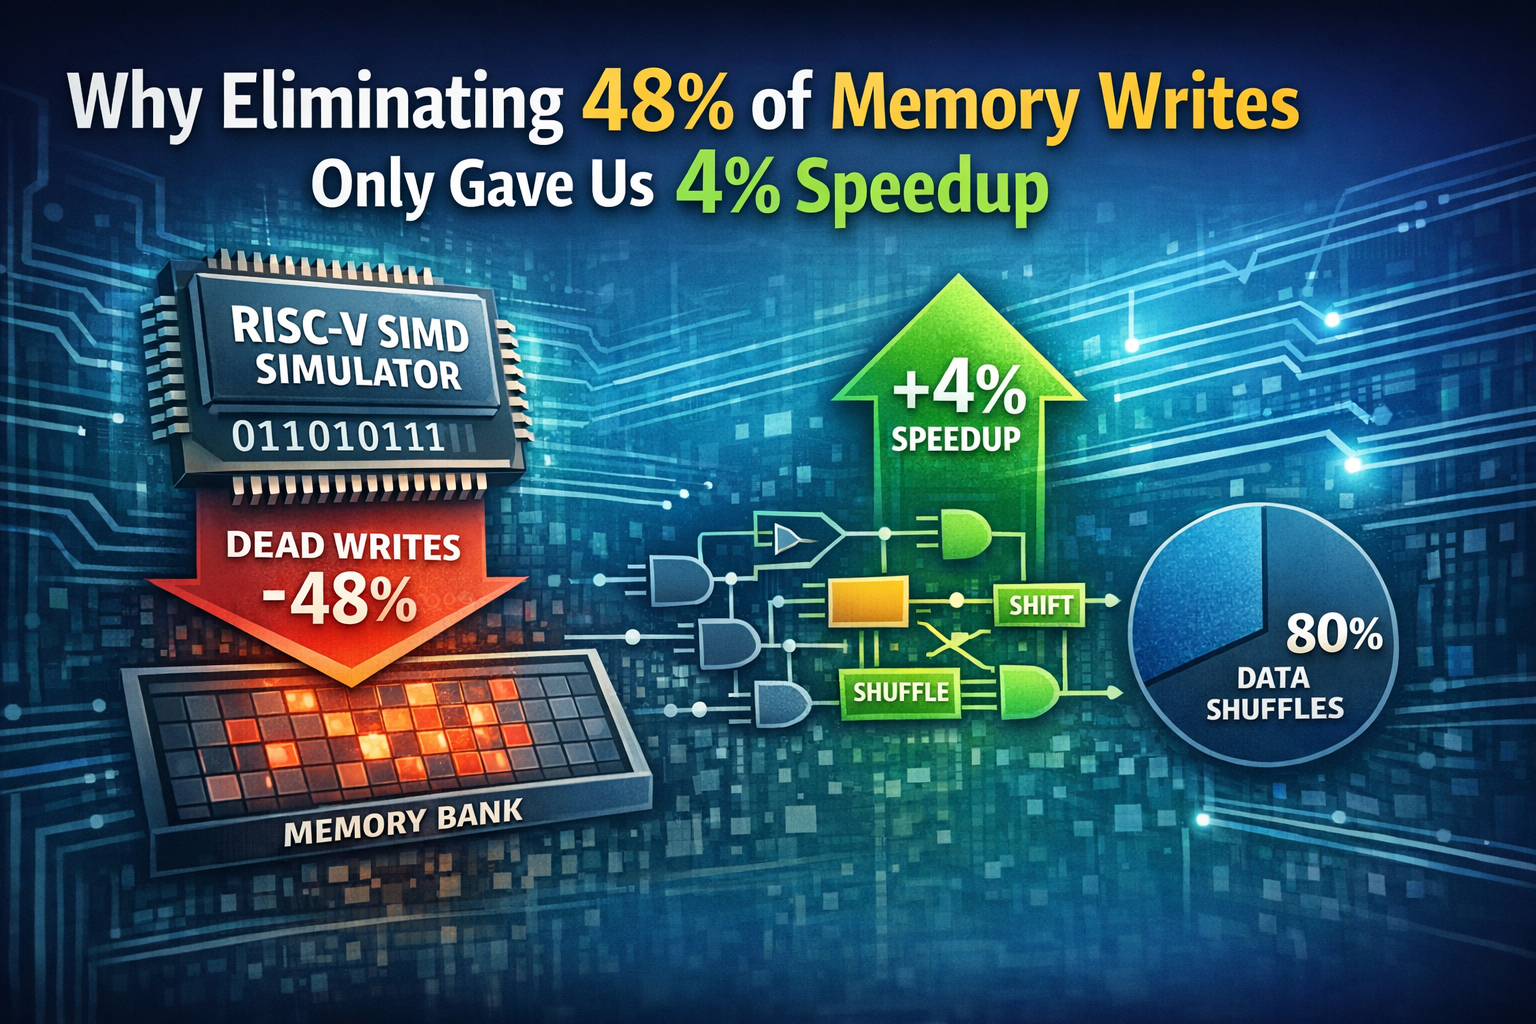
Why Eliminating 48% of Memory Writes Only Gave Us 4% Speedup
Lessons from building a bit-parallel SIMD simulator for a RISC-V CPU
-
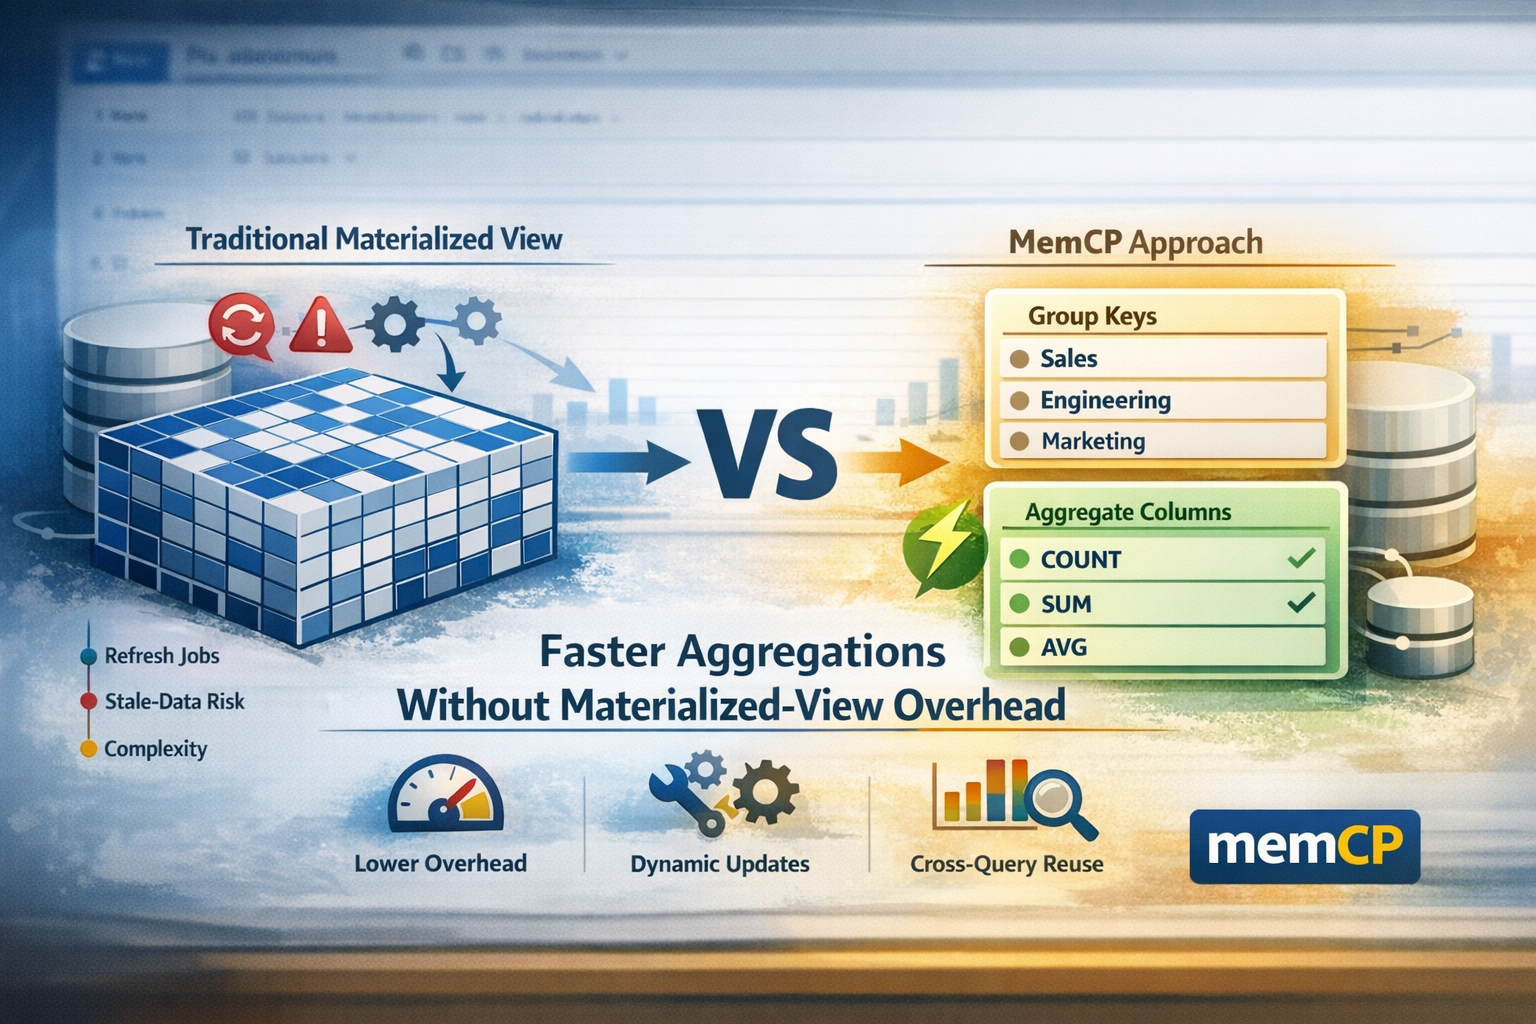
Faster Aggregations Without Materialized-View Overhead
If you run a MySQL-backed application, this pattern is probably familiar:
-
Die KI kann Ihr ERP-System selbst bedienen
Die Bedienung von ERP-Systemen verändert sich gerade grundlegend. Früher brauchte man: Heute reicht oft eine einfache Anweisung an eine KI: „Lege ein Angebot für Kunde Müller über 3 Maschinen an.” Oder: „Wostra sagt, sie lehnen das Angebot ab.” Eine KI kann daraus automatisch die passenden Aktionen im ERP ausführen. Zum Beispiel: Voraussetzung dafür ist, dass…
-
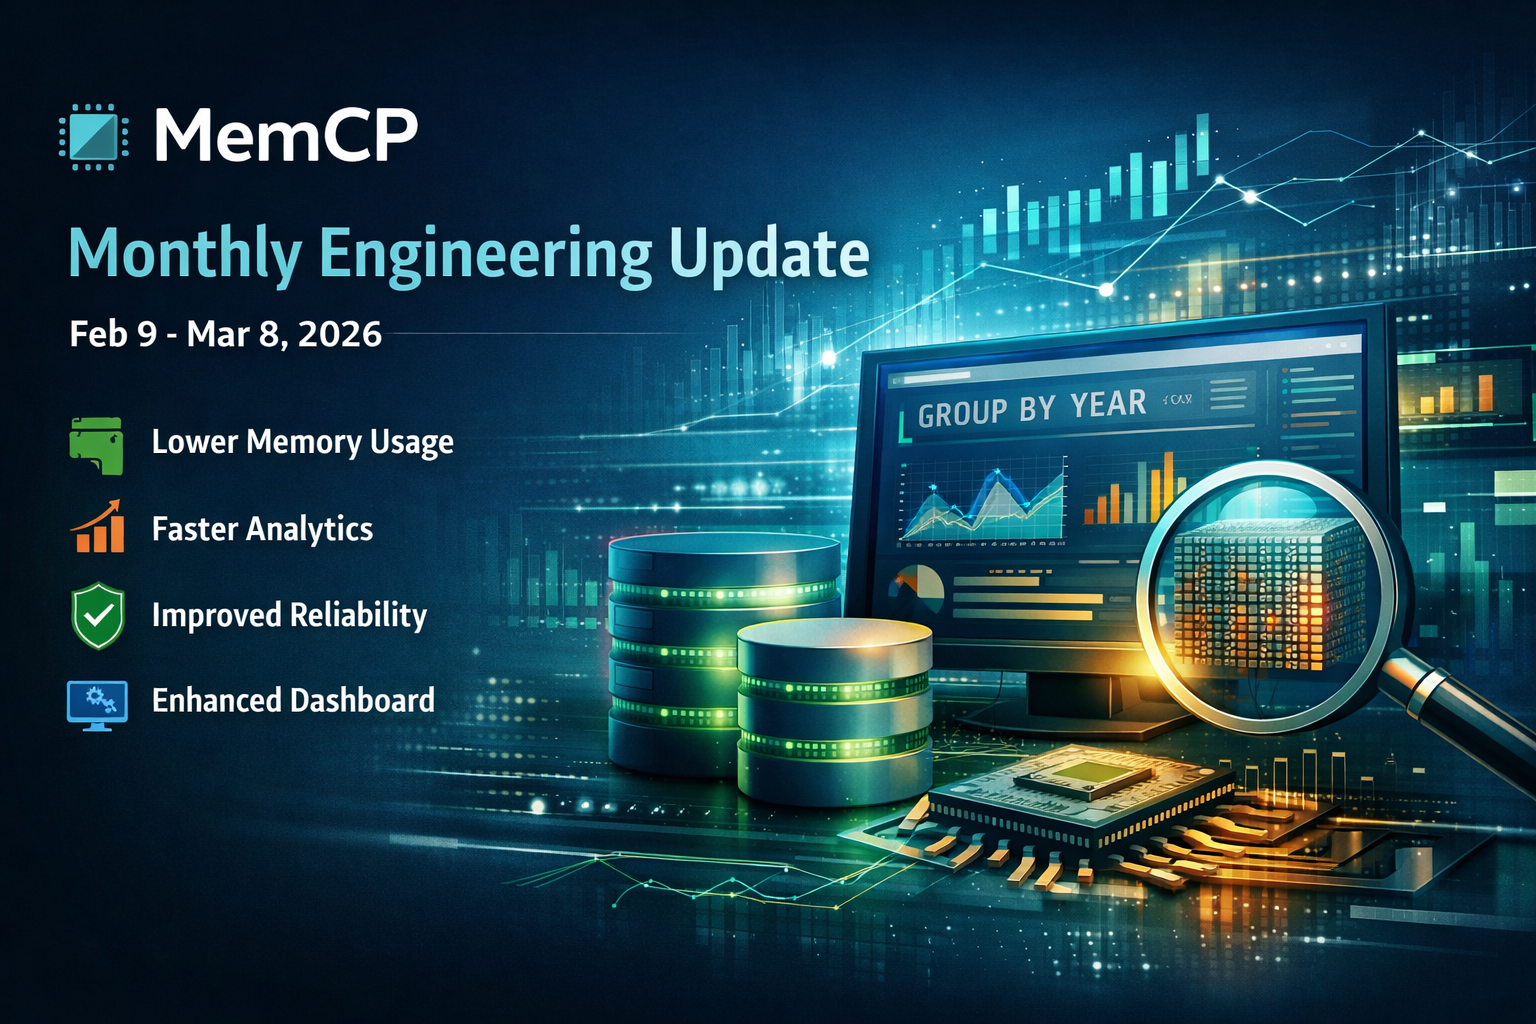
MemCP Monthly Engineering Update (Feb 9 – Mar 8, 2026)
This month delivered major practical gains: lower memory usage, faster analytics, better reliability under load, and a much stronger admin experience.
-
FOP Release 1.6
Das FOP Release enthält vor allem Stabilitäts-Fixes. Es gab keine großartigen neuen Funktionen, dafür aber eine Menge Kleinigkeiten, an denen wir gefeilt haben.
-
36% Faster Without Changing a Single Query: Inside MemCP’s New Scan Engine
MemCP is an in-memory columnar database written in Go with a Scheme scripting layer for query compilation, planning and optimization. Its storage engine organizes data into shards, each containing a compressed main storage and a small append-only delta buffer for recent writes. Until now, the two primary scan paths — unordered aggregation (scan) and ordered…
-
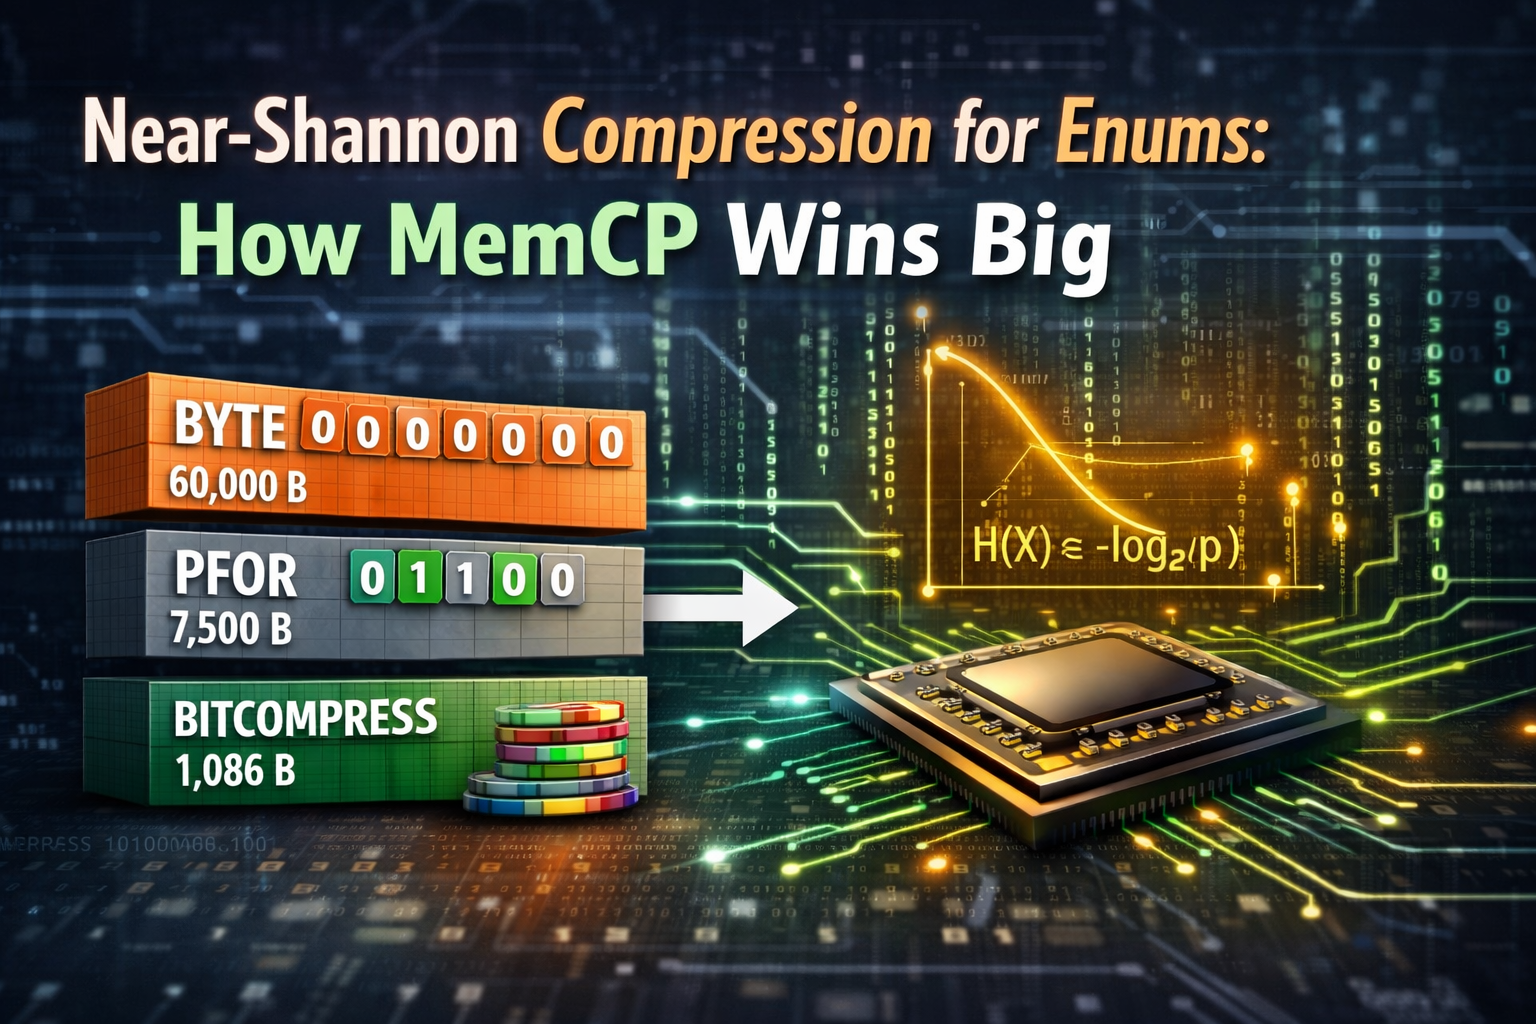
How MemCP Achieves Near-Shannon Compression for Enum Columns
MemCP is a high-performance, in-memory, column-oriented database.Columnar storage means every column is stored as a contiguous array, which opens up compression opportunities that row-based databases cannot exploit.One of the most impactful cases is enum-like columns: booleans, nullable flags, status codes, categories — any column where a small set of values repeats millions of times. This…
-
Doubling MemCP Parser Speed – Here’s How
Why Parser Speed Matters for OLTP MemCP is an in-memory, MySQL-compatible database. It handles two kinds of workloads: analytics queries that scan millions of rows, and OLTP queries — small INSERTs, UPDATEs, DELETEs, and SELECTs coming in rapid fire from applications. For OLTP / analytics queries, parsing a 1000-character SELECT takes milliseconds against a query…
-
KI vs. Datenbank – Zwischen Wahrheit und Bedeutung
Warum Datenbanken und KI gemeinsam intelligenter sind – und was das über unsere Zukunft sagt Die digitale Welt steht an einem merkwürdigen Punkt.Wir haben Maschinen gebaut, die sprechen, programmieren, erklären und argumentieren können. Gleichzeitig beruhen unsere Unternehmen, unsere Verwaltungen und unsere Wirtschaft noch immer auf etwas viel Bodenständigerem: Datenbanken. Zwischen diesen beiden Polen – exakter…
-
Warum SQL-Datenbanken immer wieder dasselbe neu ausrechnen
(Ein Beitrag für SQL-Anfänger und tägliche Nutzer)
-
MemCP January 2025: Parallel Sharding, Subselects, and MySQL Compatibility
Supercharging query performance with automatic parallel execution After an intense month of development, MemCP has gained some powerful new capabilities that dramatically improve both performance and SQL compatibility. Here’s what’s new. Parallel Sharding: From 1 Core to 19 Cores The biggest change this month is automatic parallel sharding. Previously, bulk-inserted data could end up in…
-
Digitales Auftragsbuch
Wer Aufträge noch in E-Mails, Excel-Listen und Papier-Ordnern „zusammenhält“, kennt das typische Bild: Rückfragen häufen sich, Zuständigkeiten sind unklar, Abrechnungen kommen zu spät – und wenn jemand ausfällt, fehlt plötzlich der Überblick. Ein digitales Auftragsbuch ist die Gegenbewegung dazu: ein zentraler, lebender Datensatz pro Auftrag, der alles Wichtige bündelt – von der Anfrage bis zur…
 German
 English